Pourquoi Teams a continué à fonctionner quand Outlook était en panne
La panne Microsoft de novembre 2026 n’a pas touché tous les services de la même façon. Le rapport préliminaire attribue l’écart entre Teams et Outlook à leurs chemins réseau : Teams pouvait contourner une passerelle défaillante, contrairement à Exchange Online.
La question
Question de la rédaction : avez-vous déjà constaté qu’un service numérique restait accessible alors qu’une fonction liée était en panne ?
Le 12 novembre 2026, la panne de Microsoft 365 a privé des utilisateurs d’accès à Outlook et à d’autres services. Pourtant, les appels, réunions et messages dans Teams ont globalement continué de fonctionner. Ce contraste ne signifie pas que Teams était indépendant de toute l’infrastructure Microsoft : il tient surtout à la manière dont les services pouvaient, ou non, contourner une passerelle réseau saturée.
Le rapport préliminaire de Microsoft, publié le 15 novembre dans le centre d’administration de Microsoft 365, a été résumé le lendemain par Charles Lamanna, vice-président exécutif de l’entreprise. Dans ce compte rendu, relayé par Numerama, l’explication ne se limite pas à un bug : un défaut logiciel, une charge élevée et des protections qui ont propagé le problème se sont combinés.
La différence décisive : pouvoir quitter la passerelle
Une grande partie des services Microsoft 365 passe par une même passerelle réseau, qui achemine les connexions vers les courriels, les fichiers ou les conversations. Le 12 novembre, cette infrastructure a cessé de répondre pour une large part. À son pic, plus de 80 % de ses serveurs étaient injoignables, selon le rapport préliminaire rapporté par Numerama.
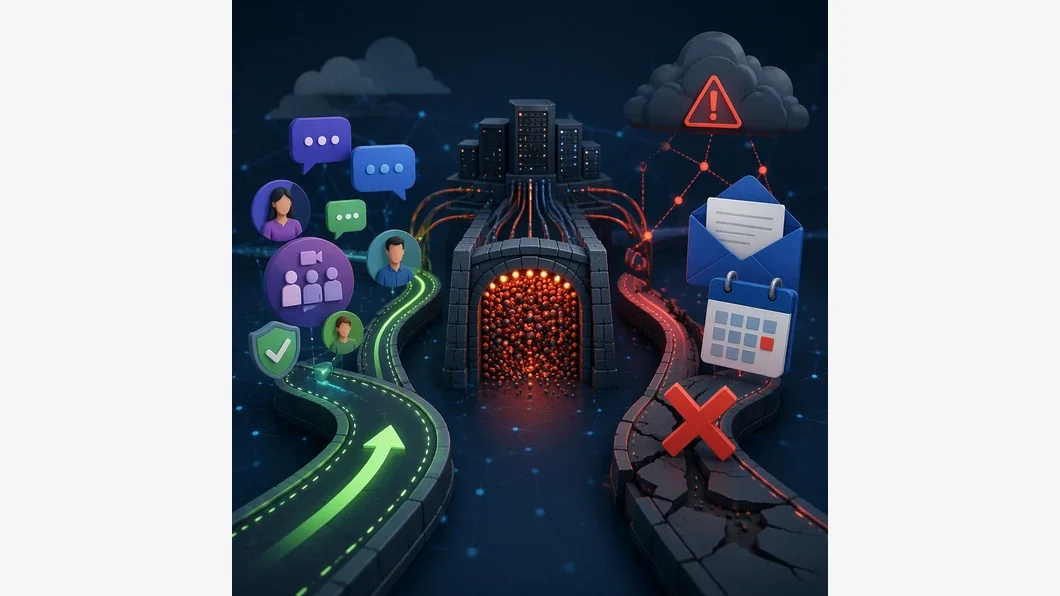
Teams, OneDrive, SharePoint et les applications Office pouvaient se retirer de cette passerelle et emprunter un autre chemin. Cette possibilité leur a permis de se rétablir en partie plus tôt. Exchange Online, le service qui fait fonctionner Outlook dans les entreprises, n’avait pas cette option : selon le rapport, son volume de trafic l’empêchait de basculer ailleurs. Les boîtes mail sont donc restées attachées à une infrastructure en panne.
Cette distinction explique pourquoi une application pouvait sembler disponible alors qu’une autre ne répondait plus. Les fonctions de conversation et de réunion dans Teams ne dépendent pas toutes du même chemin que le courrier et le calendrier.
En revanche, l’envoi et la réception des courriels, la planification du calendrier, les invitations aux réunions et l’accès de Copilot aux données d’Outlook reposaient sur Exchange Online. La présence de Teams sur un écran ne garantissait donc pas que ces fonctions liées à la messagerie étaient rétablies.
Le compte rendu de Journal du Geek rapporte également que Teams avait été basculé vers une passerelle principale quinze heures avant la panne, après avoir utilisé une passerelle secondaire. Ce changement a contribué à augmenter la charge et à modifier les flux. Il n’est pas, à lui seul, l’explication de l’incident : le rapport décrit une combinaison de facteurs.
Comment un défaut local s’est transformé en panne étendue
Le défaut se trouvait dans un processus Windows modifié par un correctif destiné aux serveurs de la passerelle. Sous forte charge, plusieurs tâches se disputaient le même verrou interne. Elles consommaient alors les ressources des machines jusqu’à épuiser processeur et mémoire. Les serveurs finissaient par ne plus répondre. Le changement avait été introduit en juillet, mais le défaut n’est apparu que lorsque certaines conditions de trafic ont été réunies.
Les tests de charge n’avaient pas fait ressortir le problème, car ils tournaient sur du matériel moins puissant que celui de la production, selon l’explication du rapport reprise par Numerama. Le jour de la panne, deux circonstances ont accru la pression : le trafic associé à Teams et la mise hors service, la veille, d’environ 14 % des serveurs de la passerelle pour une raison sans rapport avec le bug. Le Journal du Geek rapporte ces éléments à partir du résumé publié par Lamanna.
Les mécanismes automatiques censés protéger le réseau ont ensuite eu un effet aggravant. Pour gérer la saturation, le système a redirigé les requêtes des serveurs en difficulté vers ceux qui fonctionnaient encore. Mais ces serveurs étaient exposés au même défaut : à leur tour, ils ont été saturés.
En moins de deux heures, la flotte entière était touchée, d’après le rapport préliminaire. Les régions de la passerelle étaient censées être séparées par des cloisons destinées à limiter la propagation. Un autre problème, que le rapport ne détaille pas, a empêché ces barrières de jouer leur rôle.
Les étapes de l’incident, du défaut à la reprise
- Juillet 2026 : le changement logiciel à l’origine du défaut est déployé sur les serveurs concernés. Il reste invisible dans les conditions normales.
- La veille de la panne : environ 14 % de la capacité des serveurs de la passerelle est hors service pour une cause distincte. Teams passe aussi de sa passerelle secondaire à la principale, ce qui augmente la charge.
- 12 novembre, à partir de 17 h 20 à Paris : les utilisateurs commencent à perdre l’accès à Exchange Online. Le bug provoque la saturation, puis la redirection des requêtes étend le problème à d’autres serveurs.
- 13 novembre, vers 8 h 20 : Microsoft trouve une solution en ramenant le code concerné à son état antérieur et la déploie par groupes de serveurs. La reprise est lente : les machines redémarrées reçoivent immédiatement les requêtes accumulées.
- 13 novembre, à 17 h 10 : aucun client n’est alors encore affecté, selon la chronologie rapportée par Numerama.
La remise en service n’a donc pas consisté à rallumer instantanément un interrupteur. Le trafic mis en attente pouvait submerger les serveurs redémarrés, et le changement logiciel ne pouvait pas être annulé avec les outils habituels. Le retour au code antérieur, puis son déploiement par lots, a permis une reprise progressive.
Un exemple hypothétique pour comprendre la différence
Imaginons une entreprise dont une équipe tient une réunion Teams alors que plusieurs collègues ne peuvent plus ouvrir Outlook. La réunion peut continuer si le trafic Teams emprunte un chemin disponible. En revanche, un participant qui attend une invitation dans son calendrier, ou un message transmis par courriel, reste bloqué si cette fonction dépend d’Exchange Online.
Ce scénario est hypothétique, mais il illustre le mécanisme décrit dans le rapport : deux outils visibles dans le même environnement peuvent dépendre de chemins techniques différents.
Il faut aussi éviter d’en déduire que Teams a été totalement épargné. Les services ont pu se rétablir en partie plus tôt, mais le rapport décrit une panne qui a affecté une infrastructure commune et plusieurs produits. « Teams fonctionnait » résume une différence d’impact ressentie par les utilisateurs, pas une indépendance complète de l’application vis-à-vis de Microsoft 365.
Les questions utiles pour cartographier une dépendance
- Quels services dépendent de la même infrastructure réseau, même s’ils ont des interfaces différentes ?
- Un service peut-il emprunter un autre chemin si sa passerelle habituelle tombe ?
- Les tests de charge reproduisent-ils les capacités et les conditions de l’environnement de production ?
- Les mécanismes de redirection peuvent-ils reporter la saturation sur les serveurs encore disponibles ?
- Les séparations entre régions fonctionnent-elles dans le scénario précis où plusieurs protections sont sollicitées à la fois ?
Ce sont des questions de lecture du compte rendu, pas la preuve qu’une réponse précise existe pour chaque organisation. La panne montre néanmoins une limite importante des services en ligne : une interface encore accessible ne permet pas, à elle seule, de connaître les dépendances qui soutiennent chacune de ses fonctions. Pour prolonger cette réflexion sur les infrastructures numériques, voir aussi les dépendances du cloud et de l’IA en Europe.
Le rapport préliminaire explique ainsi pourquoi Teams a mieux résisté qu’Outlook : certains services pouvaient contourner la passerelle défaillante, tandis qu’Exchange Online y restait attaché. Il laisse toutefois ouverte une question technique importante : pourquoi les cloisons entre régions n’ont-elles pas contenu la panne ? Le document préliminaire ne détaille pas ce point. Il ne permet pas non plus de conclure, à lui seul, si la dépendance d’Exchange à cette passerelle sera modifiée.
L'auteur
La rédaction Acturama