Un neurone d’IA peut-il vraiment révéler ce que le modèle comprend ?
Nick Cammarata avance que certains neurones d’IA s’activent en réponse à des formes communes plutôt qu’à des concepts sans rapport. Cette hypothèse, rapportée par Futura, éclaire une piste d’interprétabilité mais ne démontre ni que les réseaux sont entièrement compris ni que cette approche suffit à les rendre sûrs.
La question
Question de la rédaction : qu’est-ce qui vous aiderait le plus à comprendre le fonctionnement interne d’une IA ?
Comprendre le rôle d’un neurone dans un modèle d’IA ne revient pas nécessairement à lui attribuer un concept unique.
Dans un article publié le 20 octobre 2026, Futura rapporte une proposition de Nick Cammarata, chercheur chez Goodfire AI et ancien employé d’OpenAI : certains neurones qui semblent associer des idées éloignées pourraient plutôt réagir à une caractéristique qu’elles ont en commun.
La piste est intéressante pour étudier les modèles, mais elle ne signifie pas que leur fonctionnement est désormais percé à jour.
Le point de départ est un problème concret d’interprétabilité : comment passer des réponses visibles d’un modèle à une explication de ce qui se déroule dans son réseau ?
Le compte rendu de Futura sur l’hypothèse de Nick Cammarata décrit les neurones artificiels comme des fonctions mathématiques, et non comme de petites cellules biologiques.
Repérer qu’un neurone s’active est donc un indice à interpréter, pas une traduction immédiate de ce que le modèle « pense ».
Le casse-tête des neurones associés à plusieurs idées
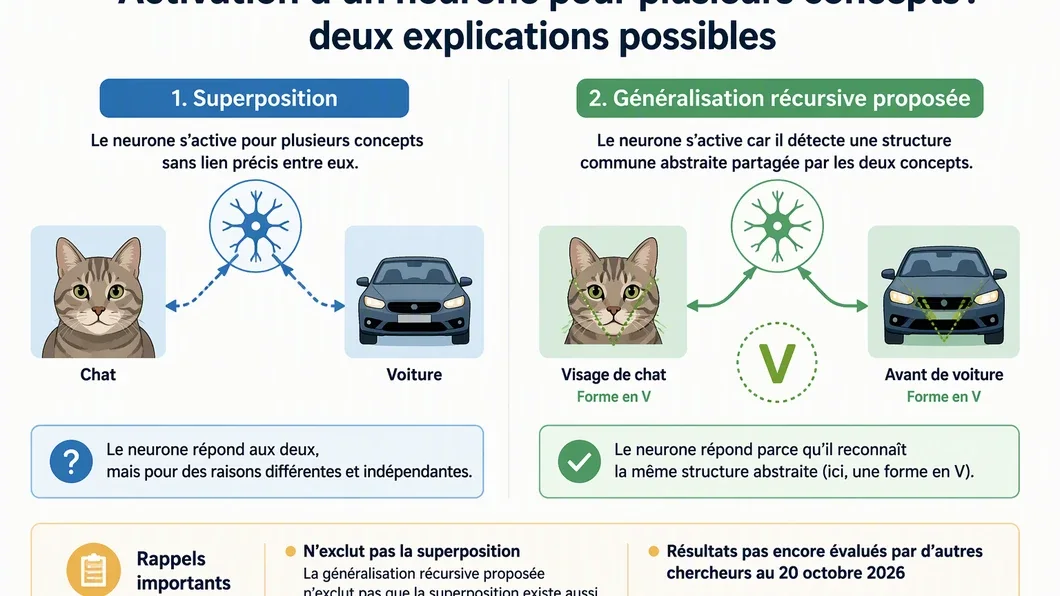
Un même neurone peut, selon l’exemple présenté par Futura, s’activer pour un chat et une voiture. Une interprétation possible est celle de la superposition : faute de neurones distincts pour chaque caractéristique, un réseau pourrait réutiliser le même neurone pour plusieurs concepts éloignés. Les activations deviennent alors difficiles à résumer par une seule étiquette.
Cammarata propose une autre lecture pour cet exemple. Le visage d’un chat et l’avant d’une voiture peuvent présenter une forme en V ; ce serait cette propriété commune, plutôt que les catégories « chat » et « voiture », qui expliquerait l’activation. Le compte rendu indique que des formes rondes, comme une balle ou un escargot, ne déclencheraient pas ce neurone dans les exemples rapportés. Cammarata nomme « généralisation récursive » le fonctionnement qu’il avance.
Cette explication déplace la question : au lieu de demander seulement « à quel objet ce neurone correspond-il ? », il faut aussi examiner les traits partagés par les exemples qui le font réagir. C’est une hypothèse de travail sur l’interprétation d’activations, pas une preuve qu’un modèle reconnaît systématiquement une forme précise ni que chaque neurone possède une signification simple.
Ce que cette piste change, et ce qu’elle ne tranche pas
Si l’explication est utile dans d’autres cas, elle pourrait aider les chercheurs à décrire plus finement certaines activations et à mieux examiner pourquoi un modèle produit un comportement inattendu. Futura rapporte que cette piste pourrait contribuer à l’interprétabilité mécaniste et, indirectement, à l’étude de l’alignement des IA. « Pourrait » est ici le mot important : comprendre un mécanisme local ne suffit pas, à lui seul, à établir comment le réseau complet se comportera.
Le compte rendu rapporte aussi des réactions contrastées. Tarun Gogineni, présenté comme employé chez OpenAI, qualifie le travail d’« étape majeure dans l’histoire de la science ». À l’inverse, Neel Nanda, de Google DeepMind, estime que cette proposition ne change pas fondamentalement le tableau général. Il souligne la difficulté de déduire le comportement d’un réseau entier à partir de ses éléments, en le comparant à celle de prévoir la météo en partant du fonctionnement des atomes.
Une nuance centrale demeure : selon Futura, l’existence éventuelle d’une généralisation récursive n’exclurait pas la superposition. Les deux explications ne sont donc pas nécessairement des options mutuellement exclusives. Et le même article précise que les résultats n’avaient pas encore été évalués par d’autres chercheurs au moment de sa publication. Les réactions enthousiastes ne remplacent pas cette étape d’examen.
Une checklist pour évaluer la portée de l’affirmation
Pour distinguer une piste prometteuse d’une conclusion établie, quelques questions permettent de garder le bon niveau de prudence :
- Quel est le résultat observé ? Ici, le compte rendu décrit des activations associées à des exemples, dont le chat et l’avant d’une voiture.
- Quelle explication est proposée ? Cammarata avance une caractéristique commune, la forme en V, plutôt qu’une association sans lien apparent.
- Les autres explications sont-elles écartées ? Non : Futura rapporte que la généralisation récursive n’exclut pas la superposition.
- Le résultat a-t-il été évalué indépendamment ? Le compte rendu indique qu’il ne l’avait pas encore été par d’autres chercheurs à la date de publication.
- Peut-on conclure que le modèle entier est compris ou sûr ? Les éléments rapportés ne permettent pas de tirer cette conclusion.
Cette façon de séparer observation, interprétation et validation rejoint la prudence nécessaire devant les prépublications scientifiques avant leur évaluation : une proposition peut mériter l’attention sans être déjà une conclusion stabilisée.
La portée réelle : mieux poser la question, pas fermer le dossier
L’intérêt de l’hypothèse est de rappeler qu’une activation partagée ne désigne pas forcément, à elle seule, un neurone « consacré » à plusieurs objets sans rapport. Une propriété visuelle commune peut être une explication à examiner. Mais l’exemple rapporté ne suffit pas à établir que cette interprétation s’applique largement, ni à régler la question du comportement collectif des neurones.
La formule de « secret des IA percé » va donc plus loin que ce que permet d’affirmer le compte rendu. Celui-ci présente une explication proposée, des réactions divergentes et une validation indépendante qui restait à venir au 20 octobre 2026. La suite dépendra notamment de l’examen critique des résultats et de leur portée : non pas seulement savoir si un neurone peut être interprété dans un exemple, mais déterminer jusqu’où cette lecture aide à comprendre un réseau complet.
L'auteur
La rédaction Acturama